A menudo se describe una plataforma de gestión de información y eventos de seguridad (SIEM) como «el sitio al que van los logs». Esa descripción oculta casi todo el trabajo. Un SIEM es tan bueno como la cadena que lo alimenta: si un eslabón falla, los ataques pasan sin una sola alerta. Esta guía recorre cada eslabón, sus fallos habituales y cómo demostrar que toda la cadena funciona.
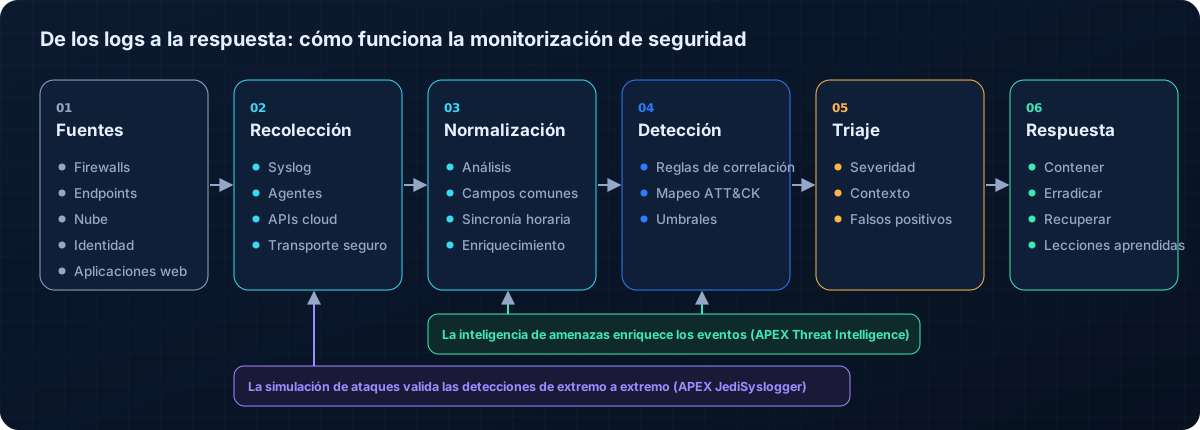
1. Fuentes de logs: decida qué necesita ver
Parta de los ataques que le preocupan, no de los dispositivos que tiene. El ransomware, el robo de cuentas y el robo de datos dejan rastros en lugares distintos:
- Identidad: los servicios de directorio, el inicio de sesión único y la autenticación multifactor muestran quién accedió, desde dónde y cómo.
- Equipos: la creación de procesos, PowerShell y la instalación de servicios muestran qué se ejecutó en una máquina.
- Red: firewalls, proxies, DNS y VPN muestran a dónde fue el tráfico.
- Nube y SaaS: los registros de auditoría de los proveedores cloud y de las suites ofimáticas muestran cambios de configuración y accesos a buzones.
- Aplicaciones: los servidores web y las aplicaciones de negocio muestran el abuso de los servicios que expone.
Una regla útil: para cada técnica de ataque prioritaria, nombre al menos una fuente de logs que la registraría. Si no hay ninguna, ha encontrado un punto ciego antes que un atacante.
2. Recolección y transporte
Los logs llegan al SIEM mediante agentes, syslog, API o colectores de eventos. Cada opción tiene sus ventajas e inconvenientes. Syslog por UDP es sencillo pero puede perder mensajes con carga; TCP añade fiabilidad; los transportes cifrados protegen los datos en tránsito. Los colectores HTTP como el HTTP Event Collector de Splunk usan tokens y agrupan los eventos de forma eficiente.
Lo más importante es saber cuándo una fuente deja de enviar. Un firewall que deja de mandar logs parece exactamente un firewall que no ve nada sospechoso. Vigile el volumen de cada fuente importante y genere una alerta cuando caiga.
3. Análisis y normalización
Cada fabricante escribe sus logs de forma distinta. Un firewall escribe src=203.0.113.45, otro SourceIP: 203.0.113.45 y un tercero pone la dirección en el séptimo campo separado por comas. El análisis (parsing) extrae los valores; la normalización los coloca en nombres de campo comunes, para que una sola regla funcione con todos.
Aquí es donde muchos SIEM fallan en silencio. Una actualización del fabricante cambia el orden de los campos, un parser deja de coincidir y los eventos llegan con los valores importantes enterrados en el texto. Las reglas que dependen de esos campos dejan de saltar, y nada lo avisa.
4. Reglas de detección y correlación
Las reglas convierten eventos normalizados en alertas. Las reglas simples coinciden con un único evento, como la creación de una cuenta de administrador. Las reglas de correlación combinan eventos en el tiempo: muchos accesos fallidos seguidos de uno correcto desde la misma dirección, o accesos desde dos países con una hora de diferencia.
Las buenas reglas están:
- Mapeadas a una técnica de ataque, idealmente de MITRE ATT&CK, para poder medir la cobertura.
- Lo bastante afinadas para no inundar a los analistas de falsos positivos.
- Documentadas, con qué significa la alerta y qué hacer a continuación.
- Probadas, con un evento que debería dispararlas y otro que no.
5. Enriquecimiento con inteligencia de amenazas
Una dirección IP en un log significa poco por sí sola. La misma dirección marcada por varias fuentes como servidor de mando y control significa mucho. El enriquecimiento añade reputación, geolocalización, propietario del activo y contexto de vulnerabilidades a los eventos, lo que permite decidir en segundos en lugar de minutos. Las plataformas de inteligencia de amenazas como APEX Threat Intelligence mantienen estos indicadores actualizados y sin duplicados.
6. Triaje y respuesta
Las alertas necesitan responsables. Defina niveles de gravedad, tiempos de respuesta y procedimientos para las alertas más comunes, y asegúrese de que cada alerta termina con una decisión: falso positivo, actividad legítima o incidente. Lo que se aprende en el triaje es la mejor fuente para ajustar reglas.
7. Demuestre que funciona
La única forma fiable de saber si un SIEM detecta un ataque es mostrárselo. Las pruebas de detección reproducen actividad de ataque realista, en los formatos que producen sus fuentes reales, y comprueban qué alertas aparecen.
| Resultado | Qué significa | Corrección habitual |
|---|---|---|
| Alerta generada | La cadena funciona para esta técnica | Volver a probar tras cambios |
| El evento llegó, sin alerta | Regla ausente o que no coincide | Escribir o ajustar la regla |
| El evento llegó sin analizar | Fallo del parser | Corregir el parser o el mapeo de campos |
| El evento no llegó | Fallo de recolección o transporte | Corregir la fuente o el colector |
APEX JediSyslogger se creó para este ciclo: genera logs en 56 formatos de dispositivos, inyecta 90 escenarios de ataque y muestra las detecciones que espera su propio motor, para compararlas con lo que alertó su SIEM.
Conclusiones
- Elija las fuentes de logs a partir de los ataques que necesita detectar.
- Vigile el volumen de las fuentes para no confundir silencio con seguridad.
- El análisis y la normalización son el eslabón más frágil de la cadena.
- Mapee las reglas a ATT&CK y pruébelas con ataques realistas, de forma periódica.